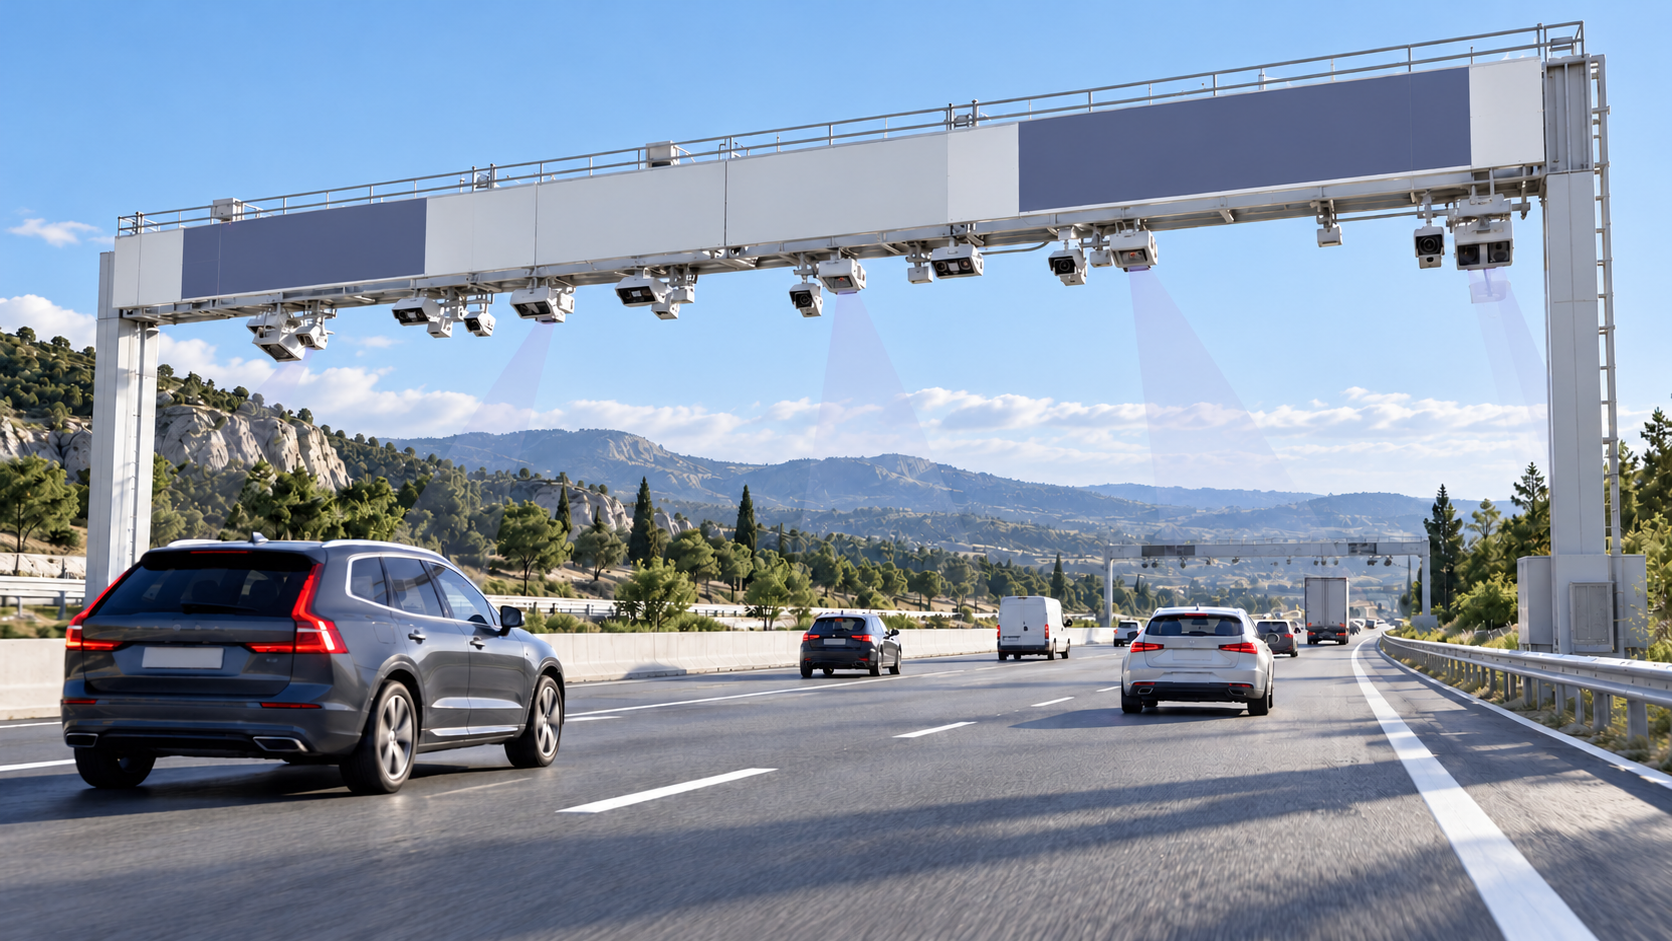
Sous un portique, la plaque devient presque la seule preuve d’identité du véhicule. Tout le projet décrit ici part de ce constat.
Le flux libre et le problème des doublettes
enregistré au fichier
passe sous le portique
- Portiquelit AB-123-CD
- Avis de paiementémis pour cette plaque
- Titulaire légitimereçoit la facture
Le principe est simple. Des portiques équipés de caméras remplacent les cabines, la lecture automatisée de plaques (LAPI) identifie chaque véhicule qui passe à pleine vitesse, et le conducteur sans badge paie après coup, en ligne ou chez un buraliste agréé, dans un délai de 72 heures. Plusieurs axes français fonctionnent déjà ainsi.
Le revers est connu des automobilistes : la doublette. Un véhicule circule avec la plaque d’un autre, et c’est le titulaire légitime qui reçoit l’avis de paiement. Avec une barrière, un agent ou une caméra de cabine voyait la voiture de près. Sous un portique, la plaque devient presque la seule preuve d’identité du véhicule.
D’où une idée de bon sens. Si la caméra reconnaît une berline d’une marque donnée et que la plaque appartient, selon le fichier officiel, à un utilitaire d’une autre marque, quelque chose cloche. Encore faut-il pouvoir interroger ce fichier en quelques millisecondes, à chaque passage.
Le cas : une API de vérification pour un concessionnaire autoroutier
Le cas se déroule chez un concessionnaire autoroutier qui déploie le flux libre. L’objectif du projet était précis : exposer une API REST capable de renvoyer, à partir d’une plaque, les caractéristiques du véhicule immatriculé, pour les confronter à ce que les portiques observent.
L’équipe a construit la chaîne complète :
- Talend DMPintégration du catalogue issu du fichier ministériel
- Normalisationredressement des marques et des modèles
- Elasticsearchindexation des véhicules
- Spring Bootbackend Java qui expose l’API REST
- GitLab CI/CDtests unitaires et fonctionnels, conteneur Docker
Sur le papier, la partie la plus visible est l’API. Dans les faits, la qualité de la réponse dépend presque entièrement de ce qui se passe en amont, dans le flux de données.
Nettoyer le fichier ministériel avec Talend
Un fichier administratif de véhicules a été alimenté pendant des années par des sources multiples. Le même constructeur y apparaît sous plusieurs graphies, les modèles mélangent nom commercial et désignation technique, les accents vont et viennent. Comparer « ce que voit la caméra » à « ce que dit le fichier » sans nettoyage préalable produirait surtout des faux positifs.
Le flux Talend a donc porté l’essentiel du redressement :
- mise en majuscules, suppression des accents et des caractères parasites ;
- table de correspondance des marques, pour ramener toutes les variantes vers un libellé de référence ;
- regroupement des modèles par famille, quand la désignation technique est trop fine pour être comparée à une classification caméra ;
- rejet tracé et visible des lignes inexploitables.
- Citroën
- CITROEN
- Citroen SA
- CITROËN AUTOMOBILES
CITROEN
Valeur brute conservée à côté, pour justifier un résultat contesté
Nos experts recommandent toujours de garder la valeur brute à côté de la valeur normalisée. Le jour où un utilisateur conteste un résultat, on veut pouvoir montrer exactement ce que contenait la source.
Chargement initial et mises à jour incrémentales
Le projet a distingué deux régimes. Le chargement initial reprend tout le catalogue et construit l’index de zéro. Les mises à jour incrémentales, elles, n’apportent que les créations, modifications et radiations survenues depuis le dernier passage.
Le piège classique se cache dans les suppressions.Un fichier incrémental qui ne contient que les nouveautés oublie facilement les véhicules retirés de la circulation, et l’index garde alors des fiches fantômes.
Il faut un indicateur explicite de radiation dans le flux, ou un rapprochement périodique complet pour purger ce qui a disparu. Les deux approches se combinent bien : l’incrémental au quotidien, une réconciliation complète à intervalle régulier.
Indexer dans Elasticsearch pour des recherches rapides
Pourquoi Elasticsearch, alors qu’une base relationnelle sait très bien chercher une clé ? Pour la tolérance. Une plaque lue par une caméra arrive avec ou sans tirets, parfois avec des espaces, en majuscules ou non. Le normalizer d’Elasticsearch permet de ramener toutes ces formes à une seule clé, à l’indexation comme à la recherche.
Voici un mapping qui va dans ce sens :
PUT /vehicules
{
  "settings": {
    "analysis": {
      "char_filter": {
        "sans_separateurs": {
          "type": "pattern_replace",
          "pattern": "[\\s\\-\\.]",
          "replacement": ""
        }
      },
      "normalizer": {
        "plaque_normalizer": {
          "type": "custom",
          "char_filter": ["sans_separateurs"],
          "filter": ["lowercase", "asciifolding"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "plaque":             { "type": "keyword", "normalizer": "plaque_normalizer" },
      "marque_brute":       { "type": "keyword" },
      "marque_normalisee":  { "type": "keyword" },
      "famille_modele":     { "type": "keyword" },
      "categorie":          { "type": "keyword" },
      "date_mise_a_jour":   { "type": "date" },
      "radie":              { "type": "boolean" }
    }
  }
}
Le normalizer s’applique à un champ keyword : la plaque reste une valeur exacte, simplement débarrassée de ses séparateurs et de sa casse. Une recherche sur « ab-123-cd » ou « AB 123 CD » tombe sur le même document.
Le normalizer en action
Trois lectures, une seule clé d’index
Ce que fait plaque_normalizer : retrait des espaces, tirets et points, passage en minuscules, suppression des accents. Saisissez une plaque pour voir la clé réellement comparée.
- ab-123-cd→ ab123cd
- AB 123 CD→ ab123cd
- AB.123.CD→ ab123cd
Un détail compte pour les performances : on interroge en term sur ce champ, en contexte de filtre. Pas de calcul de score, des résultats mis en cache, et des temps de réponse compatibles avec un portique qui envoie des lectures en continu.
Recharger l’index sans interrompre le service
Le chargement initial pose une question pratique : comment reconstruire tout le catalogue pendant que les portiques continuent d’appeler l’API ? La réponse passe par un alias. L’API passe toujours par l’alias vehicules, quel que soit l’index qui se trouve derrière. Le flux Talend construit un nouvel index daté, l’équipe vérifie les volumes et quelques plaques témoins, puis l’alias bascule d’un index à l’autre en une seule opération atomique.
vehiculesseul nom connu de l’APIEn cas de problème, on repointe l’alias vers l’ancien index et le service n’a rien vu. Ce mécanisme coûte quelques lignes de script et évite les nuits blanches.
Construire l’API Elasticsearch Spring Boot
Le backend Spring Boot reste volontairement mince. Il reçoit une plaque, interroge l’index et renvoie une fiche véhicule réduite au strict nécessaire.
@RestController
@RequestMapping("/api/v1/vehicules")
public class VehiculeController {

    private final VehiculeService vehiculeService;

    public VehiculeController(VehiculeService vehiculeService) {
        this.vehiculeService = vehiculeService;
    }

    @GetMapping("/{plaque}")
    public ResponseEntity<VehiculeDto> rechercher(@PathVariable String plaque) {
        return vehiculeService.trouverParPlaque(plaque)
                .map(ResponseEntity::ok)
                .orElse(ResponseEntity.notFound().build());
    }

    @PostMapping("/verification")
    public VerificationDto verifier(@Valid @RequestBody ObservationDto observation) {
        return vehiculeService.verifier(observation);
    }
}
La seconde route est celle qui compte pour la fraude. Elle reçoit ce que le portique a observé (plaque, marque reconnue, catégorie) et renvoie un verdict : cohérent, incohérent, ou plaque inconnue. La logique de comparaison peut être portée par une requête Elasticsearch qui cherche la plaque tout en excluant les caractéristiques observées :
GET /vehicules/_search
{
  "query": {
    "bool": {
      "filter": [
        { "term": { "plaque": "AB-123-CD" } },
        { "term": { "radie": false } }
      ],
      "must_not": [
        { "term": { "marque_normalisee": "MARQUE_OBSERVEE" } },
        { "term": { "categorie": "CATEGORIE_OBSERVEE" } }
      ]
    }
  }
}
Si la plaque existe et que cette requête renvoie un document, la marque ou la catégorie enregistrées diffèrent de l’observation : la doublette devient une hypothèse sérieuse. Le mot hypothèse est important. Une erreur de lecture caméra ou une classification approximative peuvent produire le même signal. L’API alimente donc une file de contrôle, et la décision finale revient à un traitement humain.
Observation du portiqueplaque, marque reconnue, catégorie
Recherche de la plaque dans l’indexpuis comparaison des caractéristiques
- Plaque absente de l’indexPlaque inconnue
- Marque et catégorie identiquesCohérent
- Marque ou catégorie différenteIncohérentEnvoi en file de contrôle, décision humaine
Petit conseil de terrainExposez dans la réponse le niveau de correspondance (marque seule, catégorie seule, les deux). Les équipes métier ajustent beaucoup mieux leurs règles quand elles voient pourquoi un passage a été signalé.
Une plaque est une donnée personnelle
Une plaque d’immatriculation permet de remonter au titulaire du certificat. Les traitements qui la manipulent relèvent donc du RGPD, et la CNIL encadre de près les dispositifs de lecture automatisée, notamment sur leurs finalités et leurs durées de conservation.
Pour une API de ce type, quelques réflexes s’imposent :
- renvoyer uniquement les attributs utiles à la vérification (marque, famille de modèle, catégorie), sans aucune donnée sur le titulaire ;
- authentifier les appelants et journaliser les accès ;
- définir avec le délégué à la protection des données une durée de conservation pour les traces de vérification ;
- éviter de recopier des plaques réelles dans les jeux de tests, et générer des données fictives à la place.
Ce dernier point concerne directement la chaîne de livraison.
Tester et déployer : CI/CD GitLab et Docker
La chaîne GitLab CI a été pensée en deux étages de tests. Les tests unitaires vérifient la normalisation et la logique de verdict, sans dépendance externe. Les tests fonctionnels démarrent un Elasticsearch éphémère, chargent un petit jeu de véhicules fictifs et appellent l’API comme le ferait un portique.
C’est là que se jouent les régressions les plus sournoises. Une modification anodine de la table des marques peut faire basculer des milliers de verdicts. Un jeu de cas de référence, rejoué à chaque merge request, sert de filet : plaque avec tirets, plaque sans tirets, marque écrite de trois façons, véhicule radié.
- Merge requestdéclenche la chaîne
- Tests unitairesnormalisation et logique de verdict
- Tests fonctionnelsElasticsearch éphémère, véhicules fictifs
- Cas de référencerejoués à chaque merge request
- Conteneur Dockerla version testée est celle déployée
- plaque avec tirets
- plaque sans tirets
- marque écrite de trois façons
- véhicule radié
L’application est livrée en conteneur Docker, ce qui garantit que la version testée en intégration est exactement celle déployée. Pour un service appelé en continu par des équipements de terrain, cette reproductibilité vaut cher.
Ce qu’on retient
Ce projet rappelle une évidence que l’on oublie vite : une API rapide ne vaut que par la donnée qu’elle sert. Le temps passé à redresser les marques et à fiabiliser les mises à jour incrémentales a plus pesé sur la qualité des verdicts que n’importe quel réglage de l’API. Elasticsearch apporte la tolérance de saisie et la vitesse, Spring Boot une couche de service simple à tester, et la CI/CD la confiance nécessaire pour faire évoluer les règles.
À retenir
- La donnée source fait la qualité du verdict. Redresser marques et modèles a plus pesé que tout réglage de l’API.
- Valeur brute et valeur normalisée côte à côte : c’est ce qui permet de justifier un résultat contesté.
- Les radiations sont le point faible de l’incrémental. Un indicateur explicite ou une réconciliation complète régulière évite les fiches fantômes.
- Un normalizer sur un champ keyword rend la recherche tolérante aux tirets, espaces et majuscules, avec une requête term en contexte de filtre.
- Un alias d’index permet de reconstruire le catalogue sans coupure et de revenir en arrière en une opération.
- Une doublette signalée reste une hypothèse, confirmée par un contrôle humain, et l’API n’expose aucune donnée sur le titulaire.
En résumé : la fiabilité d’un contrôle de plaque en temps réel se joue d’abord dans le flux de données, puis dans un index bien pensé et une chaîne de tests qui protège les règles métier.
Ntico Projets Digitaux
Du flux de données jusqu’à l’API qui le valorise
Chez Ntico, nous concevons ce type de chaîne de bout en bout, du flux d’intégration de données jusqu’à l’API qui la valorise, avec une attention forte à la qualité du code et à la conformité. Nos équipes Projets Digitaux couvrent l’architecture, le développement et le DevOps, du cadrage jusqu’à la mise en production.
Nos experts interviennent en renfort d’équipe, en squad produit ou en Build & Run, toujours avec un référent unique.
Vous avez un référentiel à exposer ou un contrôle à automatiser en temps réel ?
SmartData réunit plus de 70 talents Data & IA chez Ntico et a déjà accompagné plus de 40 entreprises.