Voici ce qu’on retient d’un projet de ce type mené pour un groupe de prêt-à-porter pour enfants.
Le contexte : une customer data platform GCP comme premier projet cloud
Le domaine CRM du groupe avait un besoin clair : disposer d’une vision client consolidée, exploitable par le marketing et par les data scientists. La donnée existait, mais répartie entre plusieurs applications du système d’information, avec des formats et des fréquences de mise à jour très différents.
Le projet avait une seconde dimension, moins visible au départ. Il ouvrait l’usage de Google Cloud Platform au sein du groupe. Chaque choix technique allait donc servir de référence : conventions de nommage, organisation des projets GCP, manière de livrer du code Python, gestion des droits.
Cette position de tête de file change la façon de travailler. On conçoit pour son besoin et pour les trois ou quatre équipes qui viendront après, et qui copieront ce qui existe, bonnes et mauvaises pratiques comprises.
Pourquoi construire le datalake et la CDP en même temps
La question revient souvent : faut-il d’abord un datalake propre, puis une CDP par-dessus ? Sur le papier, oui. Dans la réalité d’un domaine CRM qui attend des résultats, mener les deux de front se défend très bien.
Le datalake sert de zone d’atterrissage brute. Il garde l’historique, conserve les données telles qu’elles arrivent et permet de rejouer un traitement quand une règle métier change. La CDP, elle, porte la vision client unifiée : rapprochement des identités, attributs consolidés, segments.
Construire la CDP directement sur le socle cloud du groupe, plutôt que d’acheter une solution packagée, correspond à ce que le marché appelle aujourd’hui une CDP composable (nouvel onglet). L’intérêt est concret : la donnée client reste dans l’entrepôt de l’entreprise, sous ses règles de sécurité, et les data scientists y accèdent sans export intermédiaire.
Le découpage en couches
Dans la plupart des contextes, je recommande un découpage simple en trois zones :
- Zone bruteCloud StorageChaque source dépose ses fichiers sans transformation.
- Zone standardiséeTypage, dédoublonnage, historiqueLes données sont typées, dédoublonnées et historisées.
- Zone de restitutionBigQueryElle porte le référentiel client et les agrégats consommés par la CDP.
Rien d’exotique. La difficulté se situe ailleurs, dans la discipline avec laquelle on respecte ce découpage quand une demande urgente arrive.
Le rapprochement des identités
Le cœur d’une CDP, c’est la question « ce client du site web et ce client du magasin sont-ils la même personne ? ». Dans le prêt-à-porter, la réponse se complique vite : un parent achète pour plusieurs enfants, utilise parfois deux adresses e-mail, passe par la carte de fidélité en magasin et par un compte invité en ligne.
Ce que voit le SI
- Carte de fidélité en magasin
- Compte invité en ligne
- Adresse e-mail n° 1
- Adresse e-mail n° 2
Règles déterministes
- Identifiant de fidélité
- E-mail normalisé
- Téléphone au format international
Résultat
Un identifiant client unifiéavec la trace de la règle qui a produit chaque rapprochement
Je conseille de commencer par des règles déterministes, simples et explicables : identifiant de fidélité, e-mail normalisé, téléphone au format international. Chaque rapprochement garde la trace de la règle qui l’a produit. Les approches probabilistes viennent plus tard, une fois que le métier fait confiance au socle.
Autre point souvent négligé : un identifiant client unifié doit rester stable dans le temps. Si deux profils fusionnent, les systèmes en aval doivent savoir lequel a disparu, sinon les historiques de campagne deviennent incohérents. Une table de correspondance historisée entre anciens et nouveaux identifiants règle le problème à peu de frais.
| Ancien identifiant | Identifiant conservé | Date de fusion | Règle appliquée |
|---|---|---|---|
CLI-20481 | CLI-10077 | 2024-03-12 | E-mail normalisé |
CLI-31907 | CLI-10077 | 2024-04-02 | Identifiant de fidélité |
Alimenter le datalake depuis le SI
Les chaînes d’alimentation constituent le gros du travail. Chaque source du domaine CRM a ses particularités : extractions complètes quotidiennes pour certaines, flux incrémentaux pour d’autres, fichiers déposés par des prestataires externes.
Le principe retenu tient en une règle : chaque chargement doit être idempotent. Rejouer le traitement du 12 mars doit produire exactement le même résultat, qu’on le lance une ou cinq fois. Cela impose de partitionner les tables par date de chargement et d’écraser la partition plutôt que d’ajouter des lignes.
À tester
Rejouer le traitement du 12 mars
Le même fichier, avec deux clients, est chargé plusieurs fois. Dans le premier cas, on ajoute les lignes. Dans le second, on écrase la partition du jour.
Chargement lancé 2 fois.
Ajout de lignes
- Client A
- Client B
- Client A doublon
- Client B doublon
4 lignes pour 2 clients
Partition écrasée
Partition 2024-03-12
- Client A
- Client B
2 lignes pour 2 clients, quel que soit le nombre de relances
Le piège classique ?
Les fichiers qui arrivent en retard, ou deux fois. Sans idempotence, on découvre trois semaines plus tard des clients en double dans les segments marketing, et personne ne sait plus quel chargement les a introduits. Avec des partitions écrasées et un journal de chargement, le diagnostic prend dix minutes.
Industrialiser les paquets Python et les traitements PySpark
C’est probablement l’apport le plus durable du projet. Au départ, le code de transformation vivait dans des notebooks et des scripts copiés d’un dépôt à l’autre. Fonctionnel, mais impossible à maintenir dès que deux personnes modifient la même règle.
L’équipe a mis en place deux choses : un packaging systématique du code Python commun sous forme de paquets versionnés, et une exécution standardisée des traitements PySpark.
Packaging et publication automatisés
Les fonctions partagées (lecture des sources, règles de nettoyage, rapprochement d’identités) ont été regroupées dans des paquets Python. GitLab CI se charge de les tester, de les construire et de les publier dans un dépôt privé à chaque tag.
- testTests et couverturepytest
- buildConstructionwheel + archive zip
- publishPublication à chaque tagArtifact Registry + bucket
- .whlData scientists :
pip installdans les notebooks - .zipJobs Spark : option
--py-files
Voici une version simplifiée de ce type de pipeline, avec Artifact Registry comme dépôt :
stages:
  - test
  - build
  - publish

variables:
  PIP_REPO_URL: "https://europe-west1-python.pkg.dev/${GCP_PROJECT}/python-internal/"

test:
  stage: test
  image: python:3.11-slim
  script:
    - pip install -e ".[dev]"
    - pytest --cov=crm_pipelines tests/

build:
  stage: build
  image: python:3.11-slim
  script:
    - pip install build
    - python -m build
    - cd src && python -m zipfile -c ../dist/crm_pipelines.zip crm_pipelines/
  artifacts:
    paths:
      - dist/

publish:
  stage: publish
  image: google/cloud-sdk:slim
  rules:
    - if: $CI_COMMIT_TAG
  script:
    - pip install twine keyrings.google-artifactregistry-auth
    - python -m twine upload --repository-url "$PIP_REPO_URL" dist/*.whl dist/*.tar.gz
    - gsutil cp dist/crm_pipelines.zip "gs://${DEPS_BUCKET}/crm_pipelines/${CI_COMMIT_TAG}/"
Le wheel sert aux data scientists, qui installent le paquet dans leurs notebooks avec un simple pip install. L’archive zip sert aux jobs Spark, qui la reçoivent via l’option --py-files.
Lancer PySpark de façon reproductible
Côté exécution, l’objectif était qu’un job se lance toujours de la même manière, avec une version de code identifiée. Avec Dataproc Serverless, une soumission ressemble à ceci :
gcloud dataproc batches submit pyspark \
  gs://${DEPS_BUCKET}/jobs/build_customer_profile.py \
  --region=europe-west1 \
  --version=2.2 \
  --py-files=gs://${DEPS_BUCKET}/crm_pipelines/v1.4.0/crm_pipelines.zip \
  --service-account=sa-cdp-batch@${GCP_PROJECT}.iam.gserviceaccount.com \
  -- --run-date=2024-03-12 --mode=overwrite
La version du paquet apparaît en clair dans la commande. Quand un résultat surprend, on sait exactement quel code l’a produit. Ce détail paraît anodin jusqu’au jour où un audit demande pourquoi un segment a changé de taille.
Embarquer les data scientists dans les bonnes pratiques
Les data scientists du groupe avaient des profils solides en modélisation, moins en génie logiciel. Leur imposer du jour au lendemain revues de code, tests unitaires et pipelines aurait produit un rejet poli.
L’approche retenue a été progressive.
- D’abord
Rendre la bonne pratique plus simple que la mauvaise : un gabarit de projet prêt à l’emploi, avec la structure, les tests et le fichier de CI déjà configurés.
- Ensuite
Des sessions courtes, à partir de leur propre code, pour montrer ce qu’un test aurait évité.
- Enfin
Des revues de code bienveillantes, centrées sur deux ou trois points à chaque fois.
Je crois beaucoup à cette méthode.
Un data scientist qui a vu un test unitaire attraper sa propre régression devient le meilleur ambassadeur de la démarche auprès de ses collègues.
Activer la donnée : alimenter les outils métier depuis la CDP
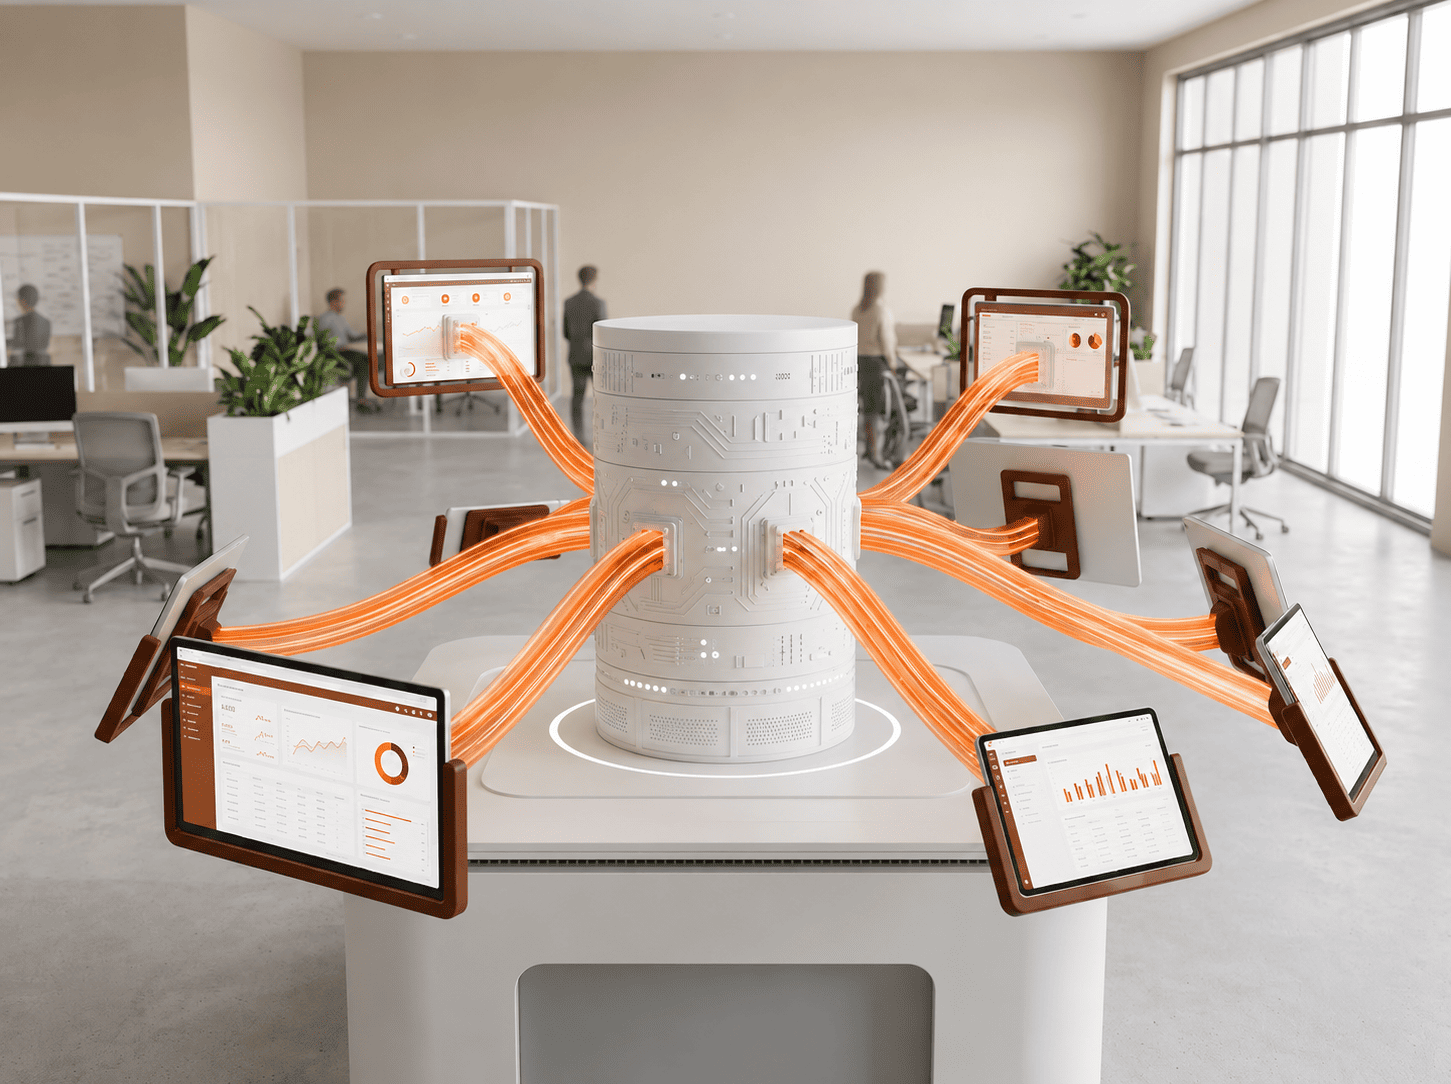
Une CDP qui ne renvoie rien vers les outils opérationnels reste un bel entrepôt. La dernière brique du projet a donc consisté à alimenter des systèmes externes à partir de la Customer Data Platform : outils de campagne, applications du SI qui avaient besoin d’attributs client consolidés.
Quelques principes se sont imposés :
exposer des tables de sortie dédiées, une par système consommateur, plutôt que laisser chaque outil interroger le référentiel ;
documenter pour chaque sortie la fréquence, le périmètre et le propriétaire métier ;
tracer chaque envoi, avec le volume transmis et la version du traitement.
Ce dernier point a servi bien au-delà de l’exploitation courante. La même traçabilité a été précieuse pour la mise en conformité avec la CNIL et la purge des données personnelles dans le SI, un chantier que nous racontons dans un article dédié.
Les pièges d’un premier projet cloud dans un groupe
Avec le recul, trois sujets méritent d’être anticipés dès le cadrage.
-
L’organisation des projets GCP
Séparer dès le départ les environnements et les domaines évite des migrations douloureuses quand d’autres équipes arrivent. Revenir sur une organisation de projets une fois vingt pipelines en production coûte cher.
-
La gestion des droits
Les comptes de service créés à la hâte, avec des rôles trop larges, sont la dette technique la plus fréquente sur GCP. Un compte par traitement, avec le minimum de permissions, demande un peu plus de rigueur au début et beaucoup moins d’inquiétude ensuite.
-
Le coût
BigQuery facture à la donnée lue. Une requête mal partitionnée lancée chaque heure par un tableau de bord peut à elle seule faire grimper la facture. Partitionner, clusteriser et surveiller les requêtes les plus coûteuses fait partie du travail d’ingénierie dès la première semaine.
À retenir
- Des fondations avant la vitrine : la vision client unifiée repose sur des chargements idempotents, du code packagé et versionné, des exécutions reproductibles et des sorties tracées.
- Trois zones bien tenues : brute dans Cloud Storage, standardisée, restitution dans BigQuery, avec la discipline de s’y tenir quand l’urgence arrive.
- Des identités explicables : règles déterministes d’abord, trace de la règle appliquée, identifiant unifié stabilisé par une table de correspondance historisée.
- Une version lisible à chaque exécution : le numéro du paquet figure dans chaque soumission PySpark, on sait quel code a produit quel résultat.
- Une adoption progressive : un gabarit prêt à l’emploi, des sessions sur le code des data scientists, des revues centrées sur deux ou trois points.
- Trois sujets à cadrer tôt : l’organisation des projets GCP, des comptes de service au minimum de permissions, le coût des requêtes BigQuery.
En résumé : une CDP sur GCP se construit d’abord sur des fondations d’ingénierie, et quand le projet ouvre le cloud pour tout un groupe, ces fondations deviennent le standard que les équipes suivantes adopteront.
Ntico Data
Du datalake à l’activation de la donnée client
Chez Ntico, nous accompagnons les entreprises dans la conception et l’industrialisation de leurs plateformes data cloud. Notre pratique Data & IA réunit architectes, data engineers et data scientists habitués à ces chantiers.
Nos équipes accompagnent les directions data et IT depuis 2010, en assistance technique, en mode projet ou en centre de services, toujours avec un référent unique. Vous lancez une CDP ou souhaitez fiabiliser une plateforme existante ? Parlons-en, nous serons ravis d’échanger sur votre contexte.
SmartData réunit plus de 70 talents Data & IA chez Ntico et a déjà accompagné plus de 40 entreprises.